1. Идея проекта
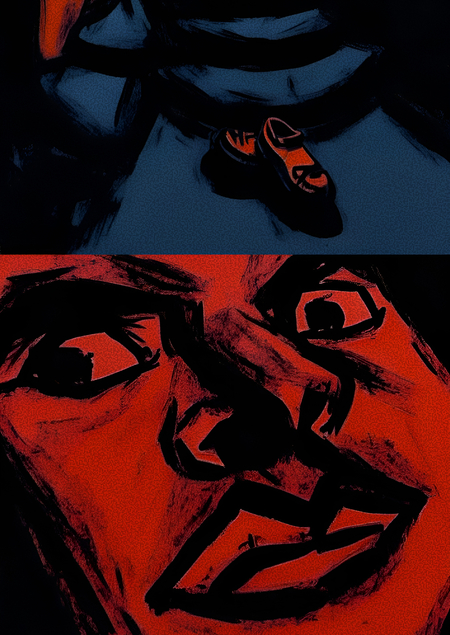
Этот проект посвящён исследованию того, может ли генеративная нейросеть освоить особенности индивидуального художественного стиля и использовать их для создания новых изображений. В качестве исходного материала я использовала собственные иллюстрации, а затем обучила дополнительную модель LoRA на базе Stable Diffusion XL.Меня интересовало не только то, насколько точно нейросеть способна воспроизводить внешний вид моих работ, но и то, сможет ли она перенести характерные особенности стиля на новые сюжеты. Мне было важно увидеть, сохранится ли визуальная узнаваемость, если вместо привычных персонажей и крупных планов предложить модели интерьеры, пейзажи, предметные композиции и абстрактные формы.В моих исходных работах важную роль играют ограниченная цветовая палитра, резкие контрасты, грубая фактура, неровные контуры и намеренно искажённые формы. Основу палитры составляют чёрный, холодный сине-серый и яркий красно-оранжевый цвета. Изображения часто строятся на крупных пятнах, выразительных силуэтах и напряжённом соотношении света и тени.В рамках проекта я рассматривала эти признаки как элементы единого визуального языка. Целью было не создание копий исходных иллюстраций, а исследование того, какие характеристики авторской манеры нейросеть сможет усвоить и воспроизвести в новых композициях.Таким образом, проект находится на пересечении авторской иллюстрации и генеративного искусства. Нейросеть здесь выступает не заменой художника, а инструментом для эксперимента: она предлагает вариации, часть которых оказывается неудачной, а часть позволяет увидеть привычный стиль в неожиданном контексте.
2. Исходные изображения и подготовка датасета
Для обучения я отобрала 14 собственных иллюстраций. Все изображения были созданы мной и использованы в качестве обучающего материала. Исходный размер файлов составлял 1330 × 1330 пикселей.При отборе работ я ориентировалась на визуальную общность: характер мазка, контрастность, цветовые отношения, особенности изображения лиц и фигур, а также общую выразительность композиции. При этом изображения не были полностью одинаковыми по содержанию. Это позволило представить модели несколько вариантов использования одного визуального языка.
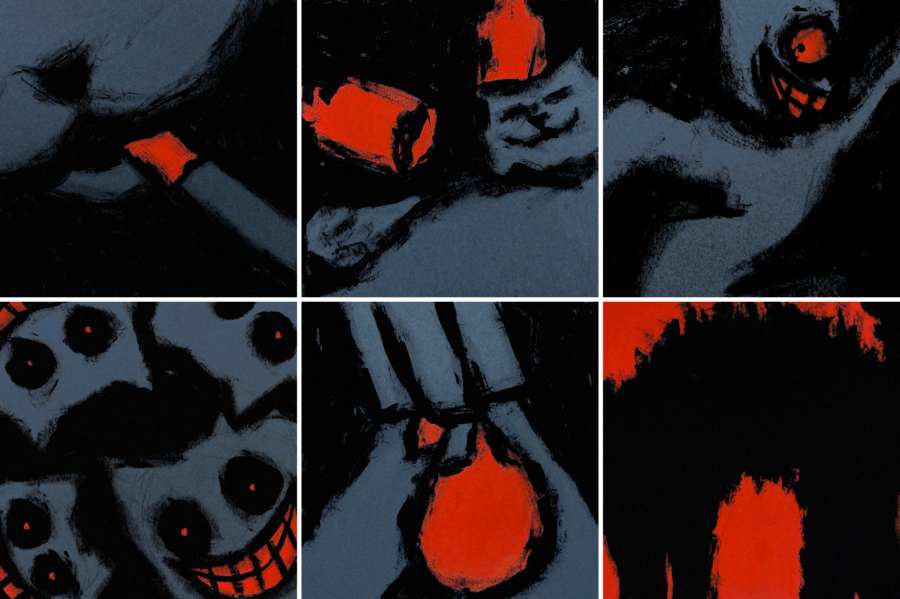
Исходные работы для обучения
В датасет вошли работы с гротескными лицами, необычными персонажами и выразительными формами. Их объединяют грубая живописная фактура, преобладание тёмных тонов и активные красно-оранжевые акценты.
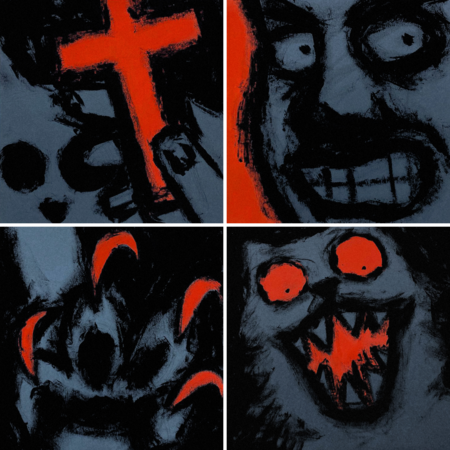
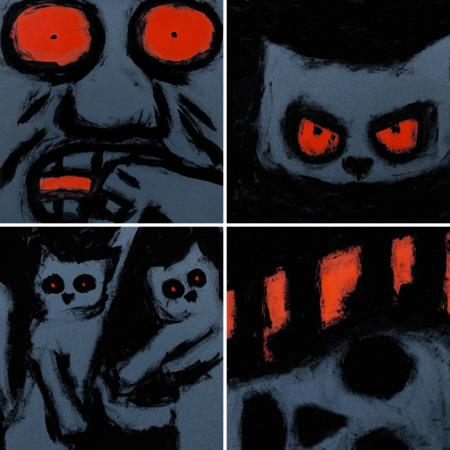
Исходные работы для обучения
Подготовка данных включала загрузку оригинальных файлов в Google Colab и их обработку для обучения. Изображения были приведены к квадратному формату, необходимому для выбранной конфигурации обучения. Для каждой работы также использовалось текстовое описание, связывающее изображение с характерными признаками стиля.Небольшой размер датасета был осознанным ограничением эксперимента. Он позволял сосредоточиться на конкретной авторской манере, но одновременно повышал вероятность того, что модель будет повторять наиболее часто встречающиеся мотивы и композиционные решения.
3. Обучение модели
Для эксперимента я использовала Stable Diffusion XL — генеративную модель, способную создавать изображения по текстовому описанию. Чтобы адаптировать её к собственным иллюстрациям, я применила метод LoRA (Low-Rank Adaptation).LoRA позволяет дообучить небольшую часть параметров модели, не переобучая всю исходную нейросеть целиком. В результате получается отдельный набор весов, который подключается к базовой модели и влияет на характер генерируемых изображений.Обучение проходило в Google Colab с использованием графического процессора NVIDIA Tesla T4. Для эксперимента были заданы 500 шагов обучения, размер пакета 1, накопление градиента за 4 шага и скорость обучения 0,0001. Использовалась смешанная точность FP16, позволяющая сократить расход видеопамяти.
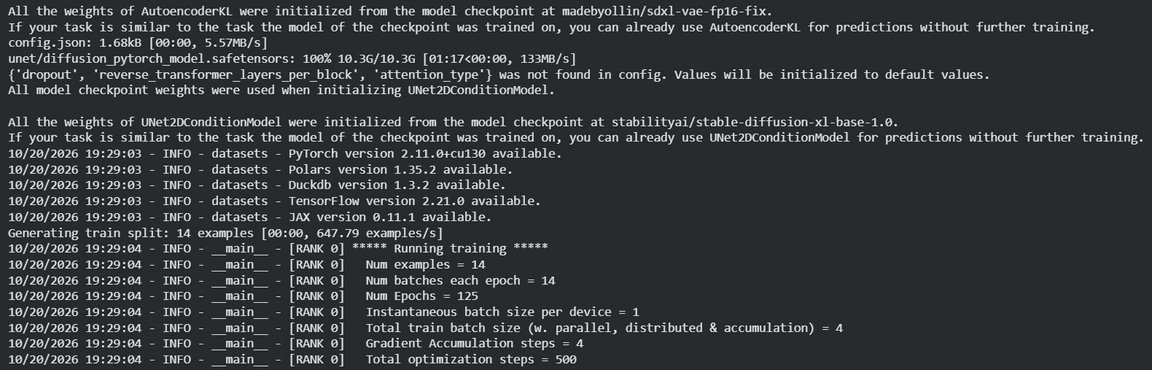
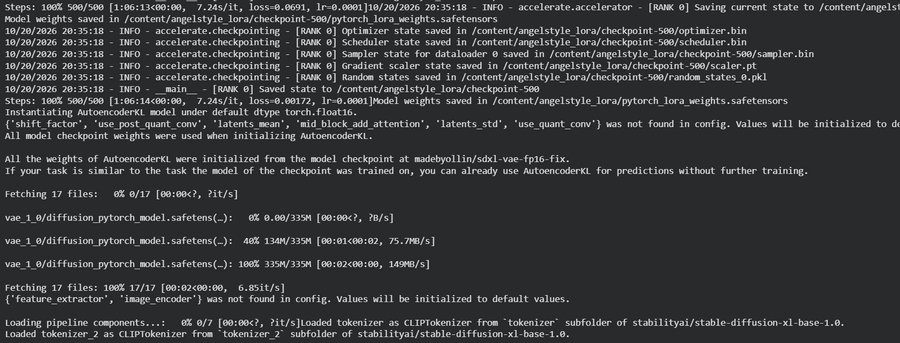
Процесс обучения
По журналу выполнения обучение заняло около 67 минут. В процессе сохранялись промежуточные контрольные точки, а по завершении были сохранены итоговые веса LoRA. Это позволило использовать результат для генерации новых изображений без повторного запуска обучения.После обучения я подключила полученные веса к Stable Diffusion XL и начала проверять, как модель работает с разными текстовыми запросами. Сначала я использовала сюжеты, близкие к исходным иллюстрациям, а затем расширила диапазон запросов: от гротескных персонажей до предметных композиций, архитектуры, пейзажей и абстрактных сцен.
Процесс обучения
4. Результирующая серия
После обучения я получила серию изображений, в которых модель использует особенности исходного визуального языка для создания новых сюжетов. Генерация проходила в несколько этапов.На первом этапе запросы были близки к исходному материалу: лица, гротескные персонажи, резкие выражения и тёмные композиции. Эти результаты показали, что модель способна воспроизводить некоторые наиболее заметные признаки моих иллюстраций.
Результат первой генерации
Результат второй генерации
На следующем этапе я стала экспериментировать с композициями и сюжетами. В запросах появились лестницы, коридоры, комнаты, странные предметы, фигуры в пространстве, архитектурные формы, растения, лодки и абстрактные объекты. При этом я сохраняла общие стилевые ориентиры: чёрный фон, холодные сине-серые оттенки, красно-оранжевые акценты и грубую фактуру.Такой подход позволил проверить, насколько далеко модель может отойти от исходных сюжетов, сохраняя визуальное сходство с авторскими работами.
Результат третьей генерации
Результат четвёртой генерации
Результат пятой генерации
Серию можно разделить на три группы:1. Близкие к исходному стилю изображения.
В них наиболее отчётливо сохраняются контрастная палитра, грубая фактура и характерные искажения форм.2. Экспериментальные сюжетные изображения. В них знакомые визуальные признаки появляются в новых сценах: интерьерах, пейзажах и предметных композициях.3. Неудачные или частично удачные результаты. В них могут повторяться мотивы, нарушаться цветовые отношения или упрощаться композиция.Такое разделение показывает, что серия не является однородным набором одинаково успешных генераций. Её ценность заключается в возможности сравнить разные степени сохранения авторского стиля и увидеть, как он меняется при работе с новыми сюжетами.
5. Анализ визуальных результатов
1. Цветовая палитра
Одним из наиболее заметных результатов стала передача основных цветовых отношений. Во многих генерациях сохраняется сочетание чёрного, холодного сине-серого и яркого красно-оранжевого. Красный цвет часто используется как главный акцент: он выделяет отдельные объекты, части композиции или направляет внимание зрителя.При этом палитра передаётся не всегда точно. В некоторых изображениях появляются дополнительные оттенки, а красные элементы занимают большую площадь, чем предполагает исходная стилистика. Иногда цветовой контраст сохраняется, но само изображение становится слишком однообразным.Это показывает, что модель усвоила общую цветовую схему, но не всегда воспроизводит её с одинаковой точностью.
Удачная генерация
Неудачная генерация
2. Фактура и характер мазкаДругой важный элемент — грубая, визуально неровная фактура. В удачных изображениях поверхность выглядит так, будто она создана сухой кистью, углём или пастелью. Контуры не всегда ровные, а отдельные формы могут частично растворяться в тёмном фоне.Именно эта особенность помогает связать изображения с исходными работами даже тогда, когда сюжет сильно отличается. В то же время некоторые генерации выглядят более гладкими и цифровыми. В них сохраняется цветовая схема, но ослабевает ощущение ручной работы.Таким образом, фактура оказалась одним из важных критериев отбора: простого совпадения цветов недостаточно, чтобы изображение воспринималось как часть авторской серии.
Удачная генерация
Неудачная генерация
3. Композиция и формыВ исходных работах выразительность часто создаётся за счёт крупных пятен, резких линий, необычных пропорций и тесного кадрирования. Модель воспроизводит эти приёмы в портретах и некоторых сюжетных сценах.Однако при расширении сюжетов возникают новые особенности. Архитектурные элементы могут наклоняться, предметы — менять пропорции, а пространство — становиться нелогичным. Иногда это воспринимается как удачный сюрреалистический приём, а иногда мешает прочитать сюжет.Эти различия особенно интересны в контексте проекта. Они показывают, что генерация не является точным переносом готового художественного решения. Модель соединяет усвоенные визуальные признаки с содержанием текстового запроса, создавая результат, который может оказаться как выразительным, так и случайным.