Описание проекта
Сейчас все больше появляется нейро-художников, которые используют нейросеть для создания контента или же для генерации идей. Если же нейросети удается поймать стиль автора, то придумать интересный референс или идею становится увлекательнее.Мне было интересно посмотреть, как у нейросети получится повторить мой стиль рисования и сможет ли она удержать стиль при различных композициях.
Библиотека изображений
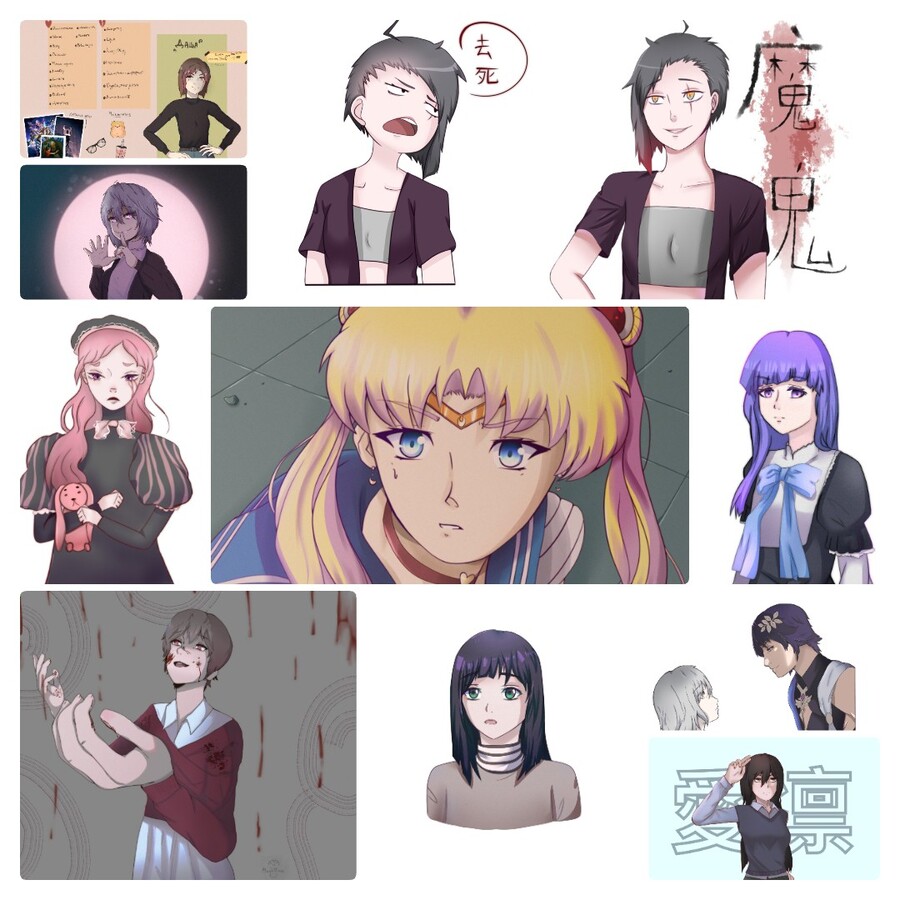
Источник изображений: личные работы автора. Все работы являются оригинальными и принадлежат автору проекта.
Для обучения я отобрала 11 личных иллюстраций, с разной композицией, набором персонажей. Главное в отборе: цветовая палитра, схожесть в стиле, какие кисти и эффекты использовала.Этой базы хватает для создания LoRA, чтобы она запомнила и смогла примерно повторить мои иллюстрации
Процесс обучения
Метод: Я дообучала Stable Diffusion XL 1.0 методом DreamBooth + LoRA. Базовую модель при этом не меняют: дообучаются только небольшие дополнительные матрицы низкого ранга, которые встраиваются в слои внимания U-Net. На выходе получается маленький файл с «весами стиля» (LoRA), который накладывается на SDXL при генерации. Это позволяет научить большую модель моей манере на небольшом датасете и на бесплатной видеокарте.
Датасет: Я собрала 11 собственных работ в одной манере (полуреалистичное аниме, мягкая светотень, чистая линия). Чтобы увеличить объём и показать модели разные масштабы, каждую работу я нарезала на три квадрата 1:1: общий план, портрет и крупный фрагмент торса. В итоге получилось 33 изображения размером 1024×1024. Подписи и водяные знаки я убрала кадрированием.
Подписи: К каждому изображению я написала короткое описание на английском (кто изображён, одежда, фон) и добавила в начало общий «ярлык» стиля: drawing in dashastyle style, … Модель учится связывать эту фразу с моей манерой, а содержание картинки описывается словами отдельно. Поэтому позже я могу управлять сюжетом через промпт, а стиль «подключать» ярлыком.Как идёт обучение: Картинки кодируются в сжатое «скрытое» представление (латенты) с помощью VAE. К латентам случайно добавляется шум разной силы, а U-Net учится предсказывать этот шум с учётом подписи. Ошибка между настоящим и предсказанным шумом (MSE) и есть функция потерь: чем она ниже, тем лучше модель «понимает», как выглядит мой стиль. Обновляются только LoRA-матрицы, а текстовые энкодеры и основная часть U-Net остаются замороженными.
Параметры:Модель: stabilityai/stable-diffusion-xl-base-1.0, VAE: madebyollin/sdxl-vae-fp16-fix.
Разрешение обучения: 512×512 (изображения автоматически уменьшаются).
Размер батча 2 с накоплением градиента 3, то есть эффективный батч 6.
Скорость обучения 1e-4, постоянная; ранг LoRA 32.
Оптимизатор 8-bit Adam, смешанная точность fp16.
snr_gamma=5.0: взвешивание потерь по уровню шума, которое делает обучение стабильнее.
500 шагов (около 90 проходов по датасету), чекпоинт каждые 250 шагов, seed 0.
Как уместить SDXL в бесплатную видеокарту: SDXL тяжёлая модель, поэтому я использовала gradient checkpointing (часть вычислений пересчитывается, чтобы экономить память), 8-битный оптимизатор, fp16 и исправленный VAE fp16-fix, который убирает артефакты и «битые» пиксели. При генерации я включала CPU offload и VAE tiling (обработку изображения частями), что позволило получать картинки 1024×1024.Генерация: Картинки создаются «с нуля» в режиме «текст-изображение»: модель стартует со случайного шума и за 25–30 шагов превращает его в рисунок по промпту. Исходные рисунки в генерации не участвуют. Силу стиля можно менять параметром scale (0 это чистая SDXL, 1.0 полный эффект LoRA). Для сравнения я использовала одинаковые промпты и seed для базовой модели и модели с LoRA.
Результирующая серия изображений
Для того, чтобы проследить, нужно ли что-то поменять и где есть пробелы, я создала первое изображение под мой стиль
drawing in dashastyle style, girl with short red hair and a green scarf, looking at the viewer, white background
В целом, мне понравилось первое изображение, текстура и лайн похожи на исходные изображения поэтому я продолжила создавать дальше
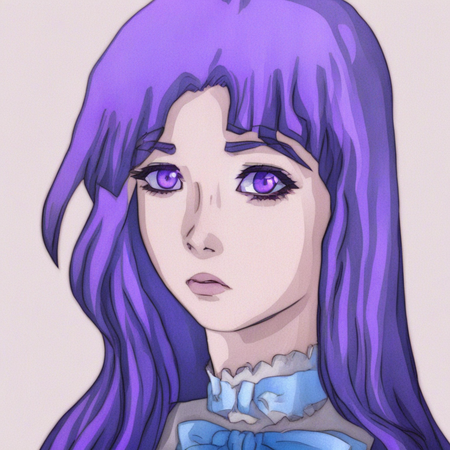
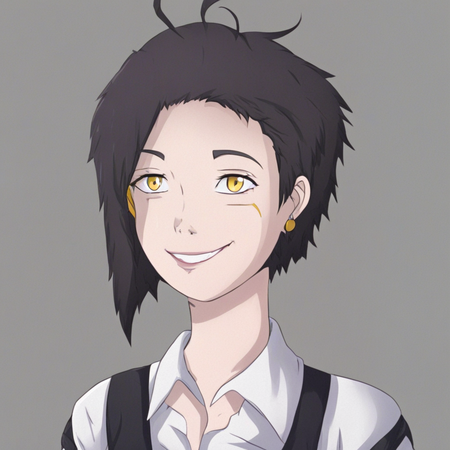
- 'drawing in dashastyle style, close-up portrait of a girl with long purple hair and violet eyes, white background', 2. 'drawing in dashastyle style, person with short dark hair and yellow eyes, smirking, hand on hip, white background',
Тут уже первое изображение слегка потеряло стиль, однако второе изображение стало даже больше похоже на стиль чем самая первая картинка
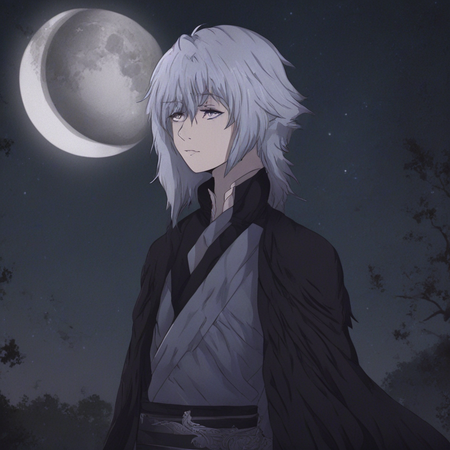
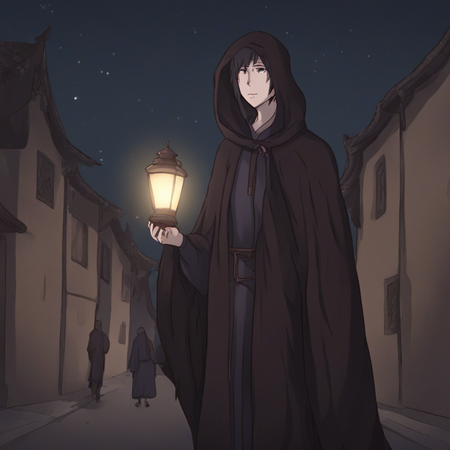
1. 'drawing in dashastyle style, boy with silver hair, black coat, big pale moon behind him, dark night', 2. 'drawing in dashastyle style, tall person in a long cloak holding a lantern, night street',
Далее я попробовала сделать работы со сложным фоном, которого обычно нет в моих работах, и хоть стилистика и хромает, но получилось довольно похоже
'drawing in dashastyle style, bust portrait of a girl with black hair and green eyes, turtleneck, white background',
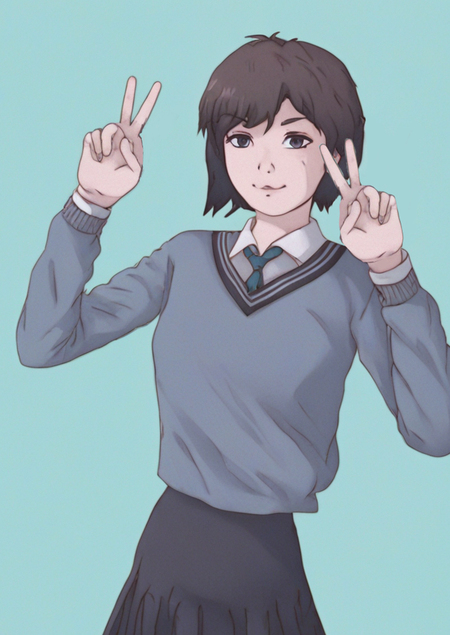
'drawing in dashastyle style, girl in a school uniform making a peace sign, pale cyan background',
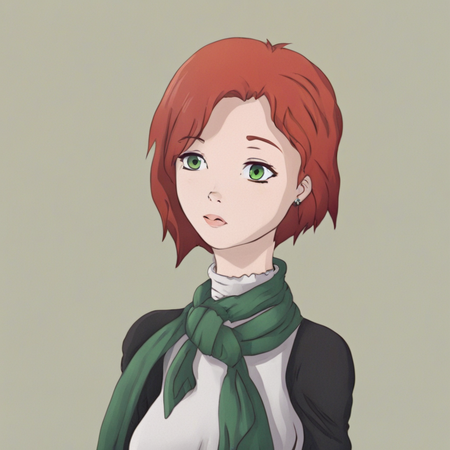
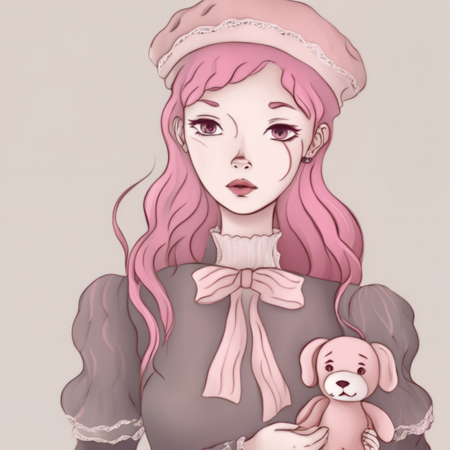
- 'drawing in dashastyle style, girl with short red hair and a green scarf, white background', 2. 'drawing in dashastyle style, girl with wavy pink hair and a beret, holding a plush toy, white background',
Все изображения рядом
Пример силы LoRA
Вывод
Что удалось передать:
1. Тип лица: Крупные глаза с выраженной линией ресниц, небольшие нос и губы, бледная кожа с мягкими розоватыми тенями. Это близко к моим полуреалистичным аниме-портретам.
2. Мягкая светотень и контур: Заливки плавные, тени сделаны широкими пятнами, а не жёсткой штриховкой, линия тонкая и тёмная.
3. Приглушённая палитра: Пыльно-розовые, серо-бежевые и бирюзовые фоны, холодные синеватые тона одежды вместо насыщенных.
4. Детали одежды и аксессуаров из датасета: рюши, банты, пышные рукава, водолазка и чокер.
5. Однотонный фон в портретах и бирюзовый фон в работе 7 повторяют решение из моих рисунков.Что получилось хуже:
1. Белый фон не соблюдён: В промптах я просила белый фон, но почти везде он получился тонированным (бежевый, серо-розовый). Сильнее сработал общий «цвет» моих работ, чем слова в промпте.
2. Просачивание деталей обучающих работ. В работе 3 появились голубой бант и кружевной воротник, хотя в промпте их не было: модель взяла их из моей работы с фиолетововолосой героиней. Это значит, что на 500 шагах часть датасета запомнилась (около 90 проходов по 33 кадрам).
3. Сложные сцены менее похожи на мой стиль. Ночные работы 2 и 8 с лунным пейзажем и улицей выглядят как более «обычное» аниме-арт: добавились реалистичный фон и плотная проработка. В моих рисунках почти нет детальных фонов, поэтому модель дописала их по-своему. В работе 2 вместо «большой бледной луны» получился тонкий серп, то есть промпт выполнен не полностью.
4. Анатомия. В работе 7 жест «пис» получился неидеально: пальцы на левой руке выглядят лишними, это типичная слабость диффузионных моделей.